به گزارش دیجیاتو، طبق پژوهش جدید مهندسان دانشگاه میشیگان، هوش مصنوعی مولد هنگام پردازش و تولید متن به زبانهای غیرانگلیسی، انرژی بسیار بیشتری مصرف میکند و گاهی پاسخهای کمدقتتری نیز ارائه میدهد. این موضوع میتواند نابرابریهای جهانی موجود را تشدید کند؛ زیرا میلیاردها نفر در سراسر جهان برای استفاده از هوش مصنوعی مجبور میشوند هزینه بیشتری بپردازند یا به زبان غیرمادری خود (انگلیسی) روی بیاورند.
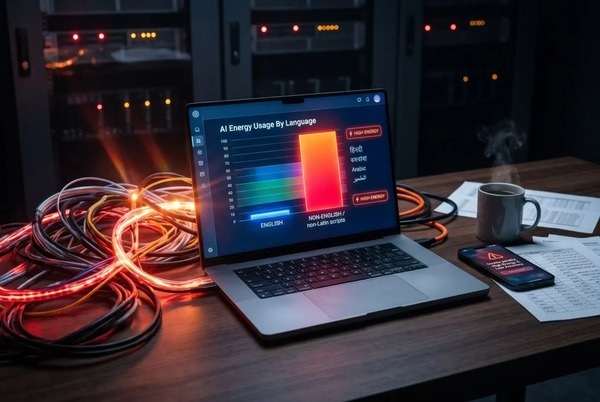
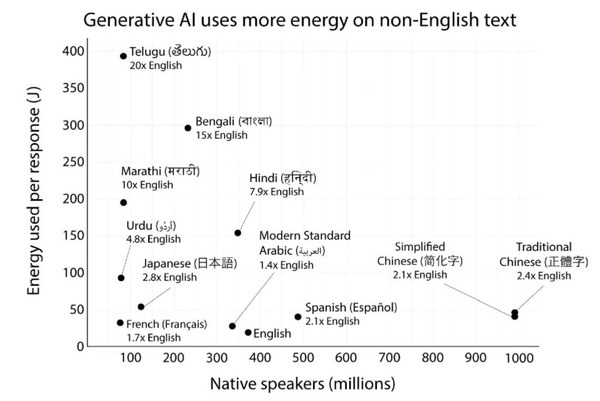
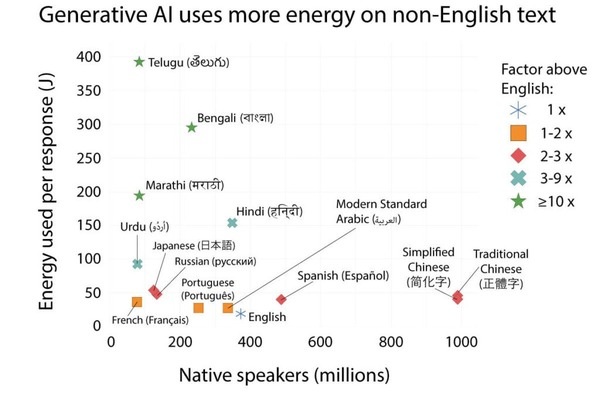
براساس یافتههای این مطالعه که در کنفرانس روشهای تجربی در پردازش زبان طبیعی (EMNLP) ارائه شده، مدلهای هوش مصنوعی برای تولید متن غیرانگلیسی بین ۱.۴ تا ۱۸۰ برابر انرژی بیشتری مصرف میکنند. بیشترین اختلاف مصرف انرژی در زبانهایی دیده میشود که از الفبای لاتین استفاده نمیکنند و محتوای دیجیتال کمتری برای آموزش مدلها دارند. درحالیکه مصرف انرژی بیشتر زبانهای اروپای غربی حداکثر دو برابر انگلیسی است، زبانهای هندی و بنگالی به ترتیب ۷.۹ و ۱۵.۳ برابر بیشتر از یک پرامپت معادل انگلیسی انرژی مصرف میکنند.
«نایهائو دِنگ»، دانشجوی دکتری علوم کامپیوتر و مهندسی در آزمایشگاه هوش مصنوعی دانشگاه میشیگان و نویسنده اول این پژوهش، میگوید زبانهایی که انرژی بیشتری مصرف میکنند، معمولاً در خروجی مدل نیز دقت پایینتری دارند. به گفته او، این «جریمه دوطرفه» باعث میشود بسیاری از افراد بهدلیل هزینههای بالا از دسترسی به هوش مصنوعی محروم شوند و شرکتها نیز تمایلی به ارائه مدلهای خود به برخی زبانها نداشته باشند.
براساس دادههای فعلی، حدود ۵.۲ میلیارد نفر در جهان برای تولید متن به زبان اول خود، بیش از دو برابر انگلیسیزبانها انرژی مصرف میکنند.
چرا مصرف انرژی هوش مصنوعی در زبانهای غیرانگلیسی بیشتر است؟
پژوهشگران برای اندازهگیری این شکاف، سه مدل هوش مصنوعی متنباز شامل Qwen 3 (علیبابا)، Gemma 3 (گوگل) و Llama 3.1 (متا) را بررسی کردند. آنها با استفاده از مجموعه داده موسوم به «Belebele» که درک مطلب مدلها را در ۱۲۲ زبان اندازه میگیرد و چارچوب اندازهگیری انرژی ML.Energy، میزان مصرف انرژی مدلها را در پاسخ به سؤالات چندگزینهای، مسائل ریاضی و پرامپتهای آزاد ارزیابی کردند. نتایج نشان داد تمام مدلها بهطور میانگین برای متن انگلیسی انرژی کمتری مصرف میکنند و این اختلاف در مدلهای بزرگتر و پردازندههای مختلف نیز وجود دارد.
علت اصلی این پدیده، تولید «توکن» بیشتر در زبانهای غیرانگلیسی است. توکن واحد پایه داده در هوش مصنوعی است و مدلها پیش از پردازش، متن را به توکن تبدیل میکنند. در زبانهایی مانند هندی و نپالی که حروف تغییر شکل میدهند و با نشانهها ترکیب میشوند، مدل مجبور است متن را به توکنهای بسیار بیشتری تقسیم کند.
تولید توکنهای بیشتر حافظه بیشتری از کامپیوتر اشغال میکند؛ در نتیجه مدل فضای کمتری برای پردازش اطلاعات دارد و مجبور میشود توکنها را در دستههای کوچکتر پردازش کند که این کار مصرف انرژی به ازایهرتوکن را بهشدت افزایش میدهد. علاوهبراین، از آنجایی که شرکتها هزینه دسترسی به مدلها را براساس تعداد توکنها محاسبه میکنند، کاربران غیرانگلیسیزبان هزینه مستقیم بیشتری نیز میپردازند.
محققان برای رفع این نابرابری پیشنهاد میکنند شرکتهای هوش مصنوعی سرویسهای خود را برای زبانهای بیشتر بهینهسازی کنند؛ برای مثال، درخواستهای کاربران را به مدلهای اختصاصی همان زبان هدایت یا پرامپتها را پیش از پردازش به انگلیسی ترجمه کنند.
- 12
- 4